さぁ、個人開発を始めよう【キックオフ編 】
はじめに
エンジニアとして働いていく中で、インフラやフロント、PMなんかも経験してくると、ふと「自分のサービス作ってみたいな」って思う瞬間、ありませんか?
僕もその一人で、まだまだ未熟ながらも「何かを形にしたい」という気持ちでこの業界に入りました。そして最近、「そろそろ自分の知見を活かして、サービス開発に挑戦してみたいな」と感じるようになりました。
このブログでは、そんな個人開発の過程を記録していきます。目指すのはサービスの立ち上げから収益化、拡大まで。 今やAIツールがかなり強力なので、ひとりでも結構やれるんじゃないか?と思ったのもきっかけです。
AIに助けてもらいながら、自分のスキルも伸ばしていけたらいいなと思ってます。何より楽しく作るのが大事。
ちなみに自己紹介はこちらに載せてます👇
https://youtrust.jp/users/0d7064346ac119ec4fedf2830a5f4856#=:embed:cite
何を作るか
寺務管理システム
最初は「ユニークなアイデア出すぞ!」とか「市場をしっかり分析して…」とか、それっぽいことをやってたんですが、やればやるほど沼にはまっていって、「あれ?何作りたかったんだっけ?」って状態に。
そのうちマーケティングの勉強ばっかりしてて、肝心の開発がまったく進まないという本末転倒な状況になってました。
なので一度リセットして、「自分にとって身近で、とっつきやすくて、ニーズもありそうな領域」で考え直しました。
そこで思い出したのが、自分の実家が寺ってこと。お寺の業界にはちょっと詳しいし、知り合いの住職も多い。しかもDX化の余地がめちゃくちゃある。そして何より、もともと「お寺業界に何か貢献したい」と思ってエンジニアになったのを思い出しました。
というわけで、まずは「寺務管理システム」を作ってみることにしました。
分析フェーズ
とはいえ、勢いだけで作り始めても失敗するのは目に見えてるので、軽く市場調査や競合分析もしてみました。
調べていくうちに、「寺務(事務作業)」だけじゃなくて、「寺業(お寺の事業全体)」まで含めてサポートできるような、もっと広い視野のプロダクトにしたいなと感じました。
価格帯については、今のところ中間層のサービスがあまり無いので、月額5,000円前後くらいがちょうど良さそうだなと考えています。
実際の調査内容や競合分析の結果は、また別の記事でまとめようと思います!(ちなみに、ChatGPTのDeepResearchめっちゃ便利だった)
PEST分析(マクロ環境要因)
政治的・法規制要因
- 寺院における個人情報管理や行政DX政策の影響
- 宗教行事のオンライン化対応の進展
経済的要因
- 少子高齢化・檀家数の減少による寺院経営の厳しさ
- 効率化・コスト削減ニーズの高まり
社会的要因
- 宗教離れ・地域過疎化による寺院の役割変化
- 寺院のサービス業的側面の強化と期待の高まり
技術的要因
3C分析
Customer(顧客)
Competitor(競合)
| サービス | 価格 | 特徴 |
|---|---|---|
| おてらブック | 低 | 帳票 |
| お寺プラス | 低 | スマホアプリあり |
| お寺まもるくん | 高 | カスタマイズ性が高い |
| 寺務台帳 | 高 | 機能数多い、サポート手厚い |
Company(自社)
- 機能豊富なクラウド寺務管理アプリ
- 中価格・サポート付き・他ツール連携可能
- UI/UX・導入しやすさ・安心感に強み
STP分析
Segmentation
- 規模(小・中・大)×ニーズ(効率化・関係強化・経営分析)
- 地域(都市・地方)×宗派(汎用)
Targeting
- 中規模寺院(100~500檀家)× IT関心あり
- エクセル管理に限界を感じている層
Positioning
- 「中価格帯で機能豊富なオールインワン型」
- 低価格~高機能サービスの中間層狙い
4P分析
Product
Price
- 月額3,980円(基本)/4,980円(プレミアム)/ カスタマイズ応相談
- 年払い割引・無料トライアル・乗換支援あり
Place
- 直販 + 一部代理店、展示会出展、ユーザー紹介・支部拡大
Promotion
- 寺院系媒体広告、導入事例PR、紹介プログラム、SNS活用
4C分析
Customer Value
- 事務効率化、情報一元化、檀家満足度向上、データ活用
Cost
- 金銭:月額3,980円前後、初期費用ゼロ、郵送費・人件費削減
- 時間:初期導入→短縮効果、心理:安心設計+サポート
Convenience
- 導入・操作が簡単、どこでも使える、マニュアル・動画充実
Communication
- 顧客との双方向対話重視、機能改善反映、檀家連絡手段あり
SWOT分析
| Strength(強み) | Weakness(弱み) |
|---|---|
| ・機能豊富・クラウド・中価格・UI/UX・柔軟性 | ・ブランド弱い・価格感・特殊要件弱い・サポート人員 |
| Opportunity(機会) | Threat(脅威) |
|---|---|
| ・IT化需要増・乗換需要・宗派連携の可能性 | ・競合の追随・市場縮小・データ事故 |
参考文献・出典:
ダミーファイルを作成せずに db:migrate:status NO FILEを回避する
環境
- Rails 7.1.2
はじめに
db:migrate:status NO FILE を回避する方法で検索すると一回ダミーファイルを作ると言う方法ばかり出てくるが、ファイルをいちいち作るのはめんどくさいので、もっとスッキリ消す方法をメモする。
結論
rails console から ActiveRecord::Base.connection.execute("DELETE FROM schema_migrations WHERE version = {VERSION ID}") を実行する
概要
【備忘録】AWS:S3 オブジェクトのコピー処理を行った際に VPC endpoints do not support cross-region requests が発生した際の対応
環境
前提
- コピー対象のobjectは 同一VPC内 かつ 同一リージョン内に存在する
事象
- 以下のような処理で同一バケット内のobjectを別の階層のobjectにコピーする処理を実行した際に、
ステータスコード403かつAws::S3::Errors::AccessDenied: VPC endpoints do not support cross-region requestsが発生した
    def backup_objects(bucket, prefix)
      bucket.objects(prefix: prefix).each do |obj|
        next if obj.key.sub(prefix, '').start_with?('bk/')

        backup_key = obj.key.sub(prefix, "#{prefix}bk/")
        bucket.object(backup_key).copy_from(
          copy_source: "#{obj.key}"
        )
        Rails.logger.info "Backup: #{obj.key} -> #{backup_key}"
      end
    end
結論
bucket.object(backup_key).copy_from(copy_source: "#{obj.key}") の引数にバケット名が不足していたこと bucket.object(backup_key).copy_from(copy_source: "#{bucket.name}/#{obj.key}") としたことで解消
プロセス
VPC endpoints do not support cross-region requestsとなっていたため、IAMロールやバケットのアクセスポリシーに問題があるのかと考えたため、ハマった。- 冷静に考えると、同一バケットへの処理なので、そんなはずなかった。(すでにIAMロールやバケットのアクセスポリシーが正常に動作している実績があったため)
Class: Aws::S3::Object — AWS SDK for Ruby V3 を見ると、bucketの指定が必要であることも確認できた
メソッドの引数に不正な値が入る時、 403エラーかつ
Aws::S3::Errors::AccessDenied: VPC endpoints do not support cross-region requestsが返るということを頭の片隅に置いておく必要がある- 存在しないパスに対してコピー処理を実行しているなら、404とかでもいい気がするけどそれは違うのだろうか
補足
- copy_fromメソッドは
5GB以上のobjectを処理する場合は、multipart_copy: trueを指定する必要がある
Ruby 再入門 Enumerable#each_with_object
Enumerable#each_with_object
与えられた任意のオブジェクトと要素をブロックに渡し繰り返し、最初に与えられたオブジェクトを返します。
- サンプルコード
- 以下のような形で、より関数型っぽい書き方ができる。
str = "hello world"
char_counts = {}

str.each_char do |char|
  counts[char] = counts.fetch(char, 0) + 1
end
puts char_counts
str = "hello world"

char_counts = str.each_char.with_object({}) do |char, counts|
  counts[char] = counts.fetch(char, 0) + 1
end
puts char_counts
Enumerable#each_with_object (Ruby 3.4 リファレンスマニュアル)
そもそもEnumerableってなんだっけ?
- 繰り返しを行なうクラスのための Mix-in。
- このモジュールのメソッドは全て each を用いて定義されているので、インクルードするクラスには each が定義されていなければなりません。
- Array, Hash, Range, Enumerator等のクラスで、 Enumerableモジュールはインクルードされています。
- ただし、効率化のため、そのクラスでEnumerableと同名・同等の機能を再定義(オーバーライド)しているケースも少なくなく、特にArrayクラスでは同名のメソッドを再定義していることが多いです。
Ruby 再入門 String#split
What is this?
- Rubyのメソッドについてリファレンスを読み直していこうと思い立ったのでそのメモ。
- 基本的には オブジェクト指向スクリプト言語 Ruby リファレンスマニュアル (Ruby 3.4 リファレンスマニュアル) を参考にしている。
String#split
- 引数に何も指定しない場合、
常に $; で分割する。 $; も nil の場合は、先頭と末尾の空白を除いたうえで、空白文字列で分割する。 $;はグローバル変数で、フィールドセパレータ (field separator) を表す。String#split メソッドに nil を渡した場合、明示的な区切り文字が指定されていないため、Ruby はデフォルトの区切り文字としてこの $; の値を使用。デフォルトでは、;の値はnil。- ただし、プログラム中で $; に別の文字列を代入することで、デフォルトの区切り文字を変更することも可能。例えば、以下のようにすると、split(nil) はコンマ (,) で文字列を分割するようになる。
- 他にも正規表現や"", " ", などを第一引数には渡すことが可能。
- 第二引数にはlimitが指定できる。
$; = ","
"apple,banana,orange".split(nil) # => ["apple", "banana", "orange"]
AWS CodePipeline・CodeBuildについてまとめみた
これは何?
デプロイを自動化しているが、それぞれのサービスが何をやっているのかいまいち理解できていなかったのでまとめてみた。
前提
Tips
基本知識
サービスごとの棲み分け
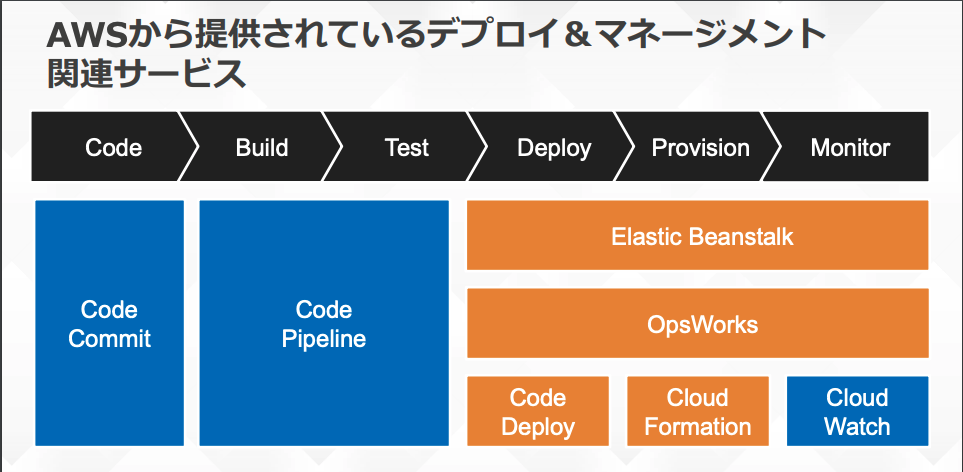
CodePipelineとは?
- AWSが提供するCI/CDを実現するサービス
CodePipelineでできること ソースリポジトリからビルド、テスト、デプロイまで、リリースプロセスの自動化。
CodeBuildとは?
今回やったこと
- 現状:codebuildに個人のgithubアカウントが紐づいていた
- 問題:アカウントが閲覧権限を持つリポジトリが見えてしまう
対応:codepipeline のソースにgithubのソースリポジトリを指定し、codebuildのソースプロバイダにcodepipelineを紐づけることで上記の問題を避ける
Codepipeline経由で、CodeBuildを作成しなおす すでに作成済みのCodeBuildのsource providerをCodePipline に変更することはできない。一度CodeBuildを削除してCodePipline経由で作り直さないといけないという仕様らしい
- 既存のCodeBuildを削除 1.該当のパイプラインの詳細>編集する
- Build-and-Deployの「ステージを編集する」
- プロジェクト名から「プロジェクトを作成する」
- 既存のCodeBuildと同様の設定を行う(環境変数とか漏れると面倒なので注意)
- Sourceの「ステージを編集する」(GitHubのアクションプロバイダーがversion1だったため)
- アクションプロバイダーで「GitHub(バージョン2)」を選択
- 左ペインの設定から「接続を選択」
- (今回は事前に作成されていたため手順割愛。以下の記事が参考になりそう。本来ならここで接続設定を行い、対象のGitHubリポジトリと接続する必要がある) Terraform を使って GitHub v2 ソースアクションでコードを取得する CodePipeline を構築する #AWS - Qiita
- 該当のパイプラインの左ペインの「設定」を選択(これがマジでわかりにくかった)
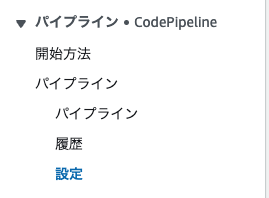
- 紐づいているサービスロールに[CodeStarConnections]を追加し、先ほど作成した接続のARNを設定する(その他必要なロールも適宜アタッチする)
例
        {
            "Action": "codestar-connections:UseConnection",
            "Effect": "Allow",
            "Resource": "arn:aws:codestar-connections:ap-northeast-1:359601428599:connection/de7f946f-fcbe-47de-8117-0c4e3055d0ba",
            "Sid": ""
        }
- 新規作成したCodeBuildのロールにも[CodeStarConnections]を追加する
- CodeBuilgのソースプロバイダがAWS CodePipelineになっていることを確認
- 適当にpushして正常に動作すれば完了
参考
https://media.amazonwebservices.com/jp/summit2015/docs/TA-05-Tokyo-Summit-2015.pdf
今後調べること
- CodeDeployをなぜ使っていないのか?
【MySQL】デッドロックについて調べてみた
これは何?
業務でデッドロックが発生。そもそもデッドロックはどのような場合に発生して、どのような対応が適切なのか?について理解が曖昧だと感じたので改めて調べてまとめた。
前提
Tips
デッドロックとはなにか?
A deadlock is a situation where different transactions are unable to proceed because each holds a lock that the other needs. Because both transactions are waiting for a resource to become available, neither ever release the locks it holds.
MySQLのリファレンスには上記のように記載されています。 「トランザクションごとにロックを専有し、トランザクション同士が互いにロックの開放を待つ状態になってしまうことでトランザクションの処理が続行できなくなること」がInnoDBにおけるトランザクションの定義でしょうか。 余談ですが、トランザクションの挙動はRDBMSによって仕様が変わるので注意してみていきたいところ。
デッドロックはどうやって発生するのか?
MySQL :: MySQL 8.0 リファレンスマニュアル :: 15.7.5.1 InnoDB デッドロックの例
デッドロックの対処方法は?
- 公式リファレンスに記載がありました(親切)
その中でもひとまずここは見ておく・改善すべきかなという点を個人の独断と偏見でピックアップしました。
SHOW ENGINE INNODB STATUSコマンドを実行して原因を特定する- データを挿入または更新するトランザクションのサイズを小さくする。
- トランザクションを再試行する。
- トランザクションを一貫性のある順序で実行する。
その他の対処方法や詳細はこちら MySQL :: MySQL 8.0 リファレンスマニュアル :: 15.7.5.3 デッドロックを最小化および処理する方法
今回はどんな事象が発生した?
後ほど更新
事象に対する仮説
InnoDB では自動行レベルロックが使用されます。 単一の行を挿入または削除するだけのトランザクションの場合でも、デッドロックが発生する可能性があります。 その原因は、これらの操作が実際には「原子的」でないためです。これらの操作では自動的に、挿入または削除される行のインデックスレコード (複数の可能性あり) にロックが設定されます。
- InnoDBでは、
自動行レベルロックが使用されている点。 - 自分の理解では行ロックとは、複数のトランザクション処理が同一のレコードに対して行われる際に発生すると考えていた。
- 実際には範囲ロックとネクストキーロックが絡んでいると思われる
感想
- デッドロックが分離レベルとは関係がないという点が自分の理解が曖昧で、当初の調査で際にそのあたりも関係があるのではないか?と調べてしまっていました。普通に考えれば「それはそう」という感じだったんですが、理解があやふやなままいると、いざ不具合に直面した際にあらぬ方向へ進んでしまい時間を無駄にしてしまうので、知識のインプットや知識の整理は仕事の効率を上げるうえでも非常に重要だなと改めて感じました。 また、参考記事にあげているようなわかりやすい記事を書いていただいている皆様には感謝の念しかありません。
